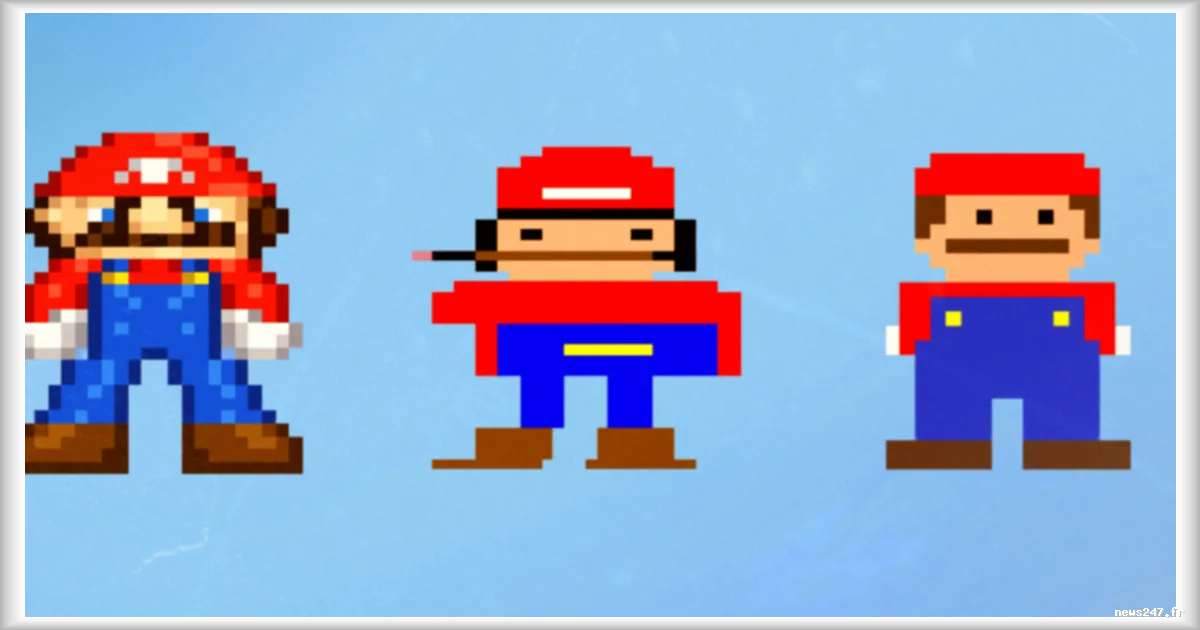
Comment une intelligence artificielle se représente-t-elle un personnage iconique comme Mario ? Pour le découvrir, un internaute a soumis une expérience originale à plusieurs modèles de langage : dessiner le célèbre plombier sur une grille de 32 × 32 pixels, sans leur fournir la moindre image de référence. Les résultats, parfois troublants de justesse, parfois méconnaissables, offrent un aperçu fascinant de la manière dont les IA reconstruisent des concepts à partir de leurs données d'entraînement, comme le rapporte Numerama.
Ce qu'il faut retenir
- 32 × 32 pixels : la taille minimale imposée pour les représentations des IA
- Aucune image fournie : les modèles devaient s'appuyer uniquement sur leurs connaissances internes
- Des interprétations variées : certaines IA ont produit des versions reconnaissables, d'autres des créations abstraites
- Un test de mémoire visuelle : l'expérience révèle la capacité des IA à synthétiser des formes à partir de descriptions textuelles
- Un outil de compréhension des IA : ces résultats éclairent les limites et les forces des modèles actuels
Une grille de pixels pour évaluer la perception des IA
L'expérience repose sur un principe simple mais efficace : contraindre les modèles de langage à produire une image de Mario dans un espace extrêmement réduit, soit 32 × 32 pixels. Cette contrainte technique force les IA à simplifier au maximum les traits caractéristiques du personnage — sa casquette rouge, sa moustache, sa salopette bleue — en une forme reconnaissable malgré tout. L'absence totale d'images de référence dans la consigne initiale garantit que les résultats ne sont pas influencés par des copies directes, mais bien par la synthèse des données apprises pendant l'entraînement, explique un internaute ayant partagé les résultats sur les réseaux sociaux.
Des créations entre reconnaissance et abstraction
Les représentations obtenues varient considérablement d'un modèle à l'autre. Certains ont produit des versions quasi parfaites, avec la casquette rouge et la salopette bleue clairement identifiables, bien que stylisées. D'autres ont généré des interprétations plus abstraites, où seuls quelques éléments — comme la moustache ou la forme générale — permettent de deviner le personnage. Ces différences soulignent la variabilité des algorithmes, certains ayant une meilleure mémoire visuelle des formes que d'autres, note Numerama. — Certains modèles semblent privilégier la cohérence globale, tandis que d'autres se concentrent sur des détails précis —.
Ce que ces résultats révèlent sur le fonctionnement des IA
Au-delà de l'aspect ludique, cette expérience offre un éclairage concret sur la manière dont les intelligences artificielles traitent les informations visuelles. En l'absence d'images, les modèles s'appuient sur des descriptions textuelles et des patterns appris pour reconstruire une représentation. Cela montre à la fois la puissance de ces systèmes — capables de générer des formes cohérentes à partir de rien — et leurs limites, comme l'abstraction excessive ou les erreurs de proportions. — Autant dire que les IA ne « voient » pas comme nous, mais reconstruisent à partir de probabilités —.
« Ces résultats illustrent comment les modèles de langage intègrent et restituent des concepts visuels, même en l'absence de données visuelles directes. C'est une fenêtre sur leur « mémoire » interne »
Un chercheur en IA, cité par Numerama
Un outil pour tester les capacités des modèles
Cette expérience s'inscrit dans une série de tests visant à évaluer les limites des intelligences artificielles. En soumettant les modèles à des contraintes artificielles — comme une grille de pixels réduite ou l'absence d'images — les développeurs et chercheurs peuvent mieux comprendre comment ces systèmes traitent et restituent l'information. Ces benchmarks sont cruciaux pour améliorer la précision des IA, notamment dans des domaines comme la reconnaissance d'images ou la génération de contenu visuel, où la cohérence est essentielle.
En attendant, cette expérience rappelle une évidence : les intelligences artificielles, aussi performantes soient-elles, fonctionnent encore différemment de nous. Leurs représentations, aussi fidèles soient-elles, restent le fruit d'un calcul statistique plutôt que d'une véritable compréhension.
D'après Numerama, l'expérience a été menée sur plusieurs modèles de langage populaires, mais les noms exacts n'ont pas été précisés. Les résultats suggèrent une diversité de performances, certains modèles produisant des représentations plus reconnaissables que d'autres.