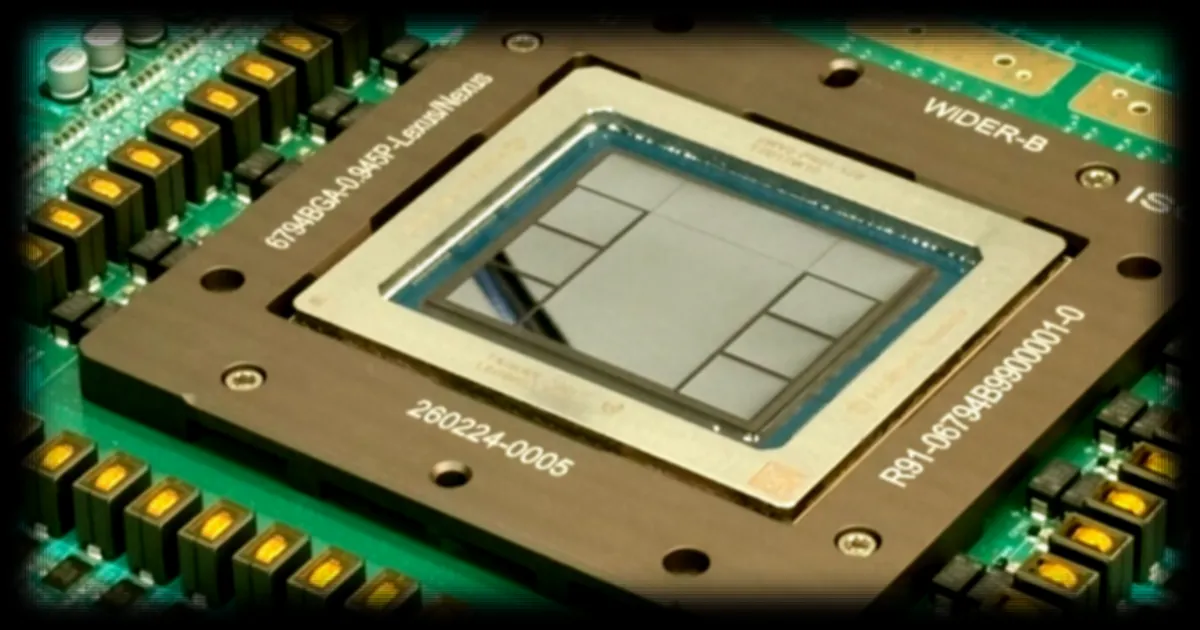
OpenAI franchit une nouvelle étape dans son indépendance technologique. Selon nos confrères du Journal du Geek, l’entreprise a développé sa première puce dédiée à l’inférence des modèles d’intelligence artificielle. Baptisée Jalapeño, cette puce marque un tournant stratégique pour OpenAI, qui cherche à réduire sa dépendance aux fournisseurs externes, notamment Nvidia.
Ce qu'il faut retenir
- OpenAI lance Jalapeño, sa première puce dédiée à l’inférence des modèles d’IA, développée avec Broadcom.
- L’objectif est de mieux contrôler les coûts, les performances et la consommation énergétique des centres de données.
- Jalapeño affiche de meilleurs résultats que certaines puces concurrentes en termes de tokens produits par mégawatt.
- La puce a déjà été utilisée pour exécuter un portage du jeu Doom, démontrant sa polyvalence.
- La production en masse est prévue pour 2027, avec des volumes significatifs attendus en fin d’année.
Une puce conçue pour l’inférence, cœur de métier d’OpenAI
Quand un utilisateur interroge ChatGPT, le modèle d’IA ne s’entraîne pas en temps réel. Il mobilise en revanche l’inférence : une phase où le système applique les connaissances acquises précédemment pour générer du texte, du code ou d’autres contenus. C’est précisément cette étape que vise à optimiser Jalapeño, la nouvelle puce maison d’OpenAI. Selon le Journal du Geek, cette puce représente une avancée majeure pour l’entreprise, qui jusqu’ici dépendait largement de solutions externes, comme celles de Nvidia.
Autonomie technologique et réduction des coûts
Concevoir sa propre puce permet à OpenAI de mieux maîtriser trois paramètres clés : les coûts, les performances et la consommation énergétique. Le projet, mené en collaboration avec Broadcom, un spécialiste des semi-conducteurs, aurait été lancé au milieu de l’année 2024. Le design final de Jalapeño a été envoyé en fabrication en novembre 2025, selon les informations recueillies par le Journal du Geek.
Jalapeño n’est pas réservée aux modèles internes d’OpenAI. Selon les tests réalisés par SemiAnalysis, qui a pu examiner la puce dans les laboratoires d’OpenAI, elle serait capable de faire tourner différents grands modèles de langage. Pour preuve, OpenAI l’a utilisée pour exécuter un portage du jeu vidéo Doom, en collaboration avec Codex. Cet exemple, bien que marginal, illustre la flexibilité de la puce, qui ne se limite pas à un usage exclusif.
Des performances énergétiques supérieures aux concurrents
Les premiers résultats partagés par OpenAI, et partiellement vérifiés par SemiAnalysis, sont encourageants. La puce afficherait des performances supérieures à plusieurs de ses concurrentes sur un critère crucial : le nombre de tokens produits par mégawatt. Un token correspond à une unité de texte traitée par un modèle d’IA. Plus une puce génère de tokens avec une consommation énergétique réduite, plus elle est intéressante pour une entreprise comme OpenAI, dont les centres de données doivent servir des millions d’utilisateurs.
Autant dire que l’enjeu dépasse le simple cadre technique. Les centres de données ne sont pas limités uniquement par leur capacité à acquérir des puces, mais aussi par leur accès à l’énergie. Une puce plus efficace permet donc d’optimiser les ressources existantes et de servir davantage d’utilisateurs sans surcoût.
Une synergie entre matériel et logiciel
La partie logicielle joue également un rôle central dans cette innovation. OpenAI s’appuie sur Gluon, son langage de programmation dédié, ainsi que sur Codex pour accélérer l’écriture et l’optimisation de certains segments de code bas niveau. Autrement dit, l’entreprise utilise ses propres outils d’IA pour améliorer l’efficacité avec laquelle sa puce exécute les modèles. Une approche qui pourrait donner un avantage concurrentiel significatif.
Une prudence nécessaire avant généralisation
Malgré ces résultats prometteurs, il convient de rester mesuré. Les données disponibles proviennent d’OpenAI, même si SemiAnalysis affirme avoir pu en vérifier une partie sur place. Tous les tests ne sont pas encore finalisés, notamment ceux simulant des usages longs et complexes. Jalapeño existe bel et bien, mais elle est encore sous forme d’échantillons d’ingénierie. La montée en production est prévue progressivement en 2027, avec des volumes significatifs attendus plutôt en fin d’année.
Une stratégie alignée sur les besoins futurs
Cette initiative s’inscrit dans une dynamique plus large chez OpenAI. L’entreprise cherche à réduire sa dépendance aux acteurs externes, tout en optimisant ses infrastructures pour répondre à la demande croissante en calcul intensif. Avec Jalapeño, OpenAI mise sur une solution sur mesure, capable de s’adapter à ses besoins spécifiques tout en ouvrant la voie à des usages variés.
Reste à voir si cette puce pourra tenir ses promesses à grande échelle. Si les résultats se confirment, elle pourrait devenir un élément clé de la stratégie industrielle d’OpenAI, redéfinissant les standards de l’inférence en intelligence artificielle.
L’innovation technologique reste un pilier pour OpenAI, qui continue de repousser les limites de l’intelligence artificielle. Avec Jalapeño, l’entreprise franchit une étape supplémentaire vers une autonomie accrue, tout en ouvrant de nouvelles perspectives pour l’industrie des semi-conducteurs dédiés à l’IA.
Concevoir sa propre puce permet à OpenAI de mieux contrôler ses coûts, ses performances et sa consommation énergétique. Actuellement, l’entreprise dépend fortement de solutions externes comme celles de Nvidia. Une puce maison offre une plus grande flexibilité et pourrait réduire les coûts à long terme, selon le Journal du Geek.
La production en masse est prévue pour 2027, avec des volumes significatifs attendus plutôt en fin d’année. Les premières unités existent déjà sous forme d’échantillons d’ingénierie, mais tous les tests ne sont pas encore finalisés, précise le Journal du Geek.